確率変数とは?サイコロの例で直感的にわかる統計学の超基本【2026】
データ分析やAIの実務活用が当たり前となった現在、統計検定の学習やビジネスでのデータ活用を始める人の多くが最初に立ち止まるのが「確率変数」という言葉です。学校数学で扱った「未知の数 $x$」と同じ感覚で捉えようとして、かえって混乱してしまうケースが後を絶ちません。
専門書を開くと抽象的な数式が並びがちですが、本質は拍子抜けするほどシンプルです。偶然に左右される現象を数値化し、データとして扱うための「土台のルール」さえ掴めば、統計学の基礎は一気に視界が開けます。
📌 【この記事の重要ポイントまとめ】
- 要点1:確率変数は「偶然の結果によって値が決まる変数」であり、事象を数値に変換する架け橋となる。
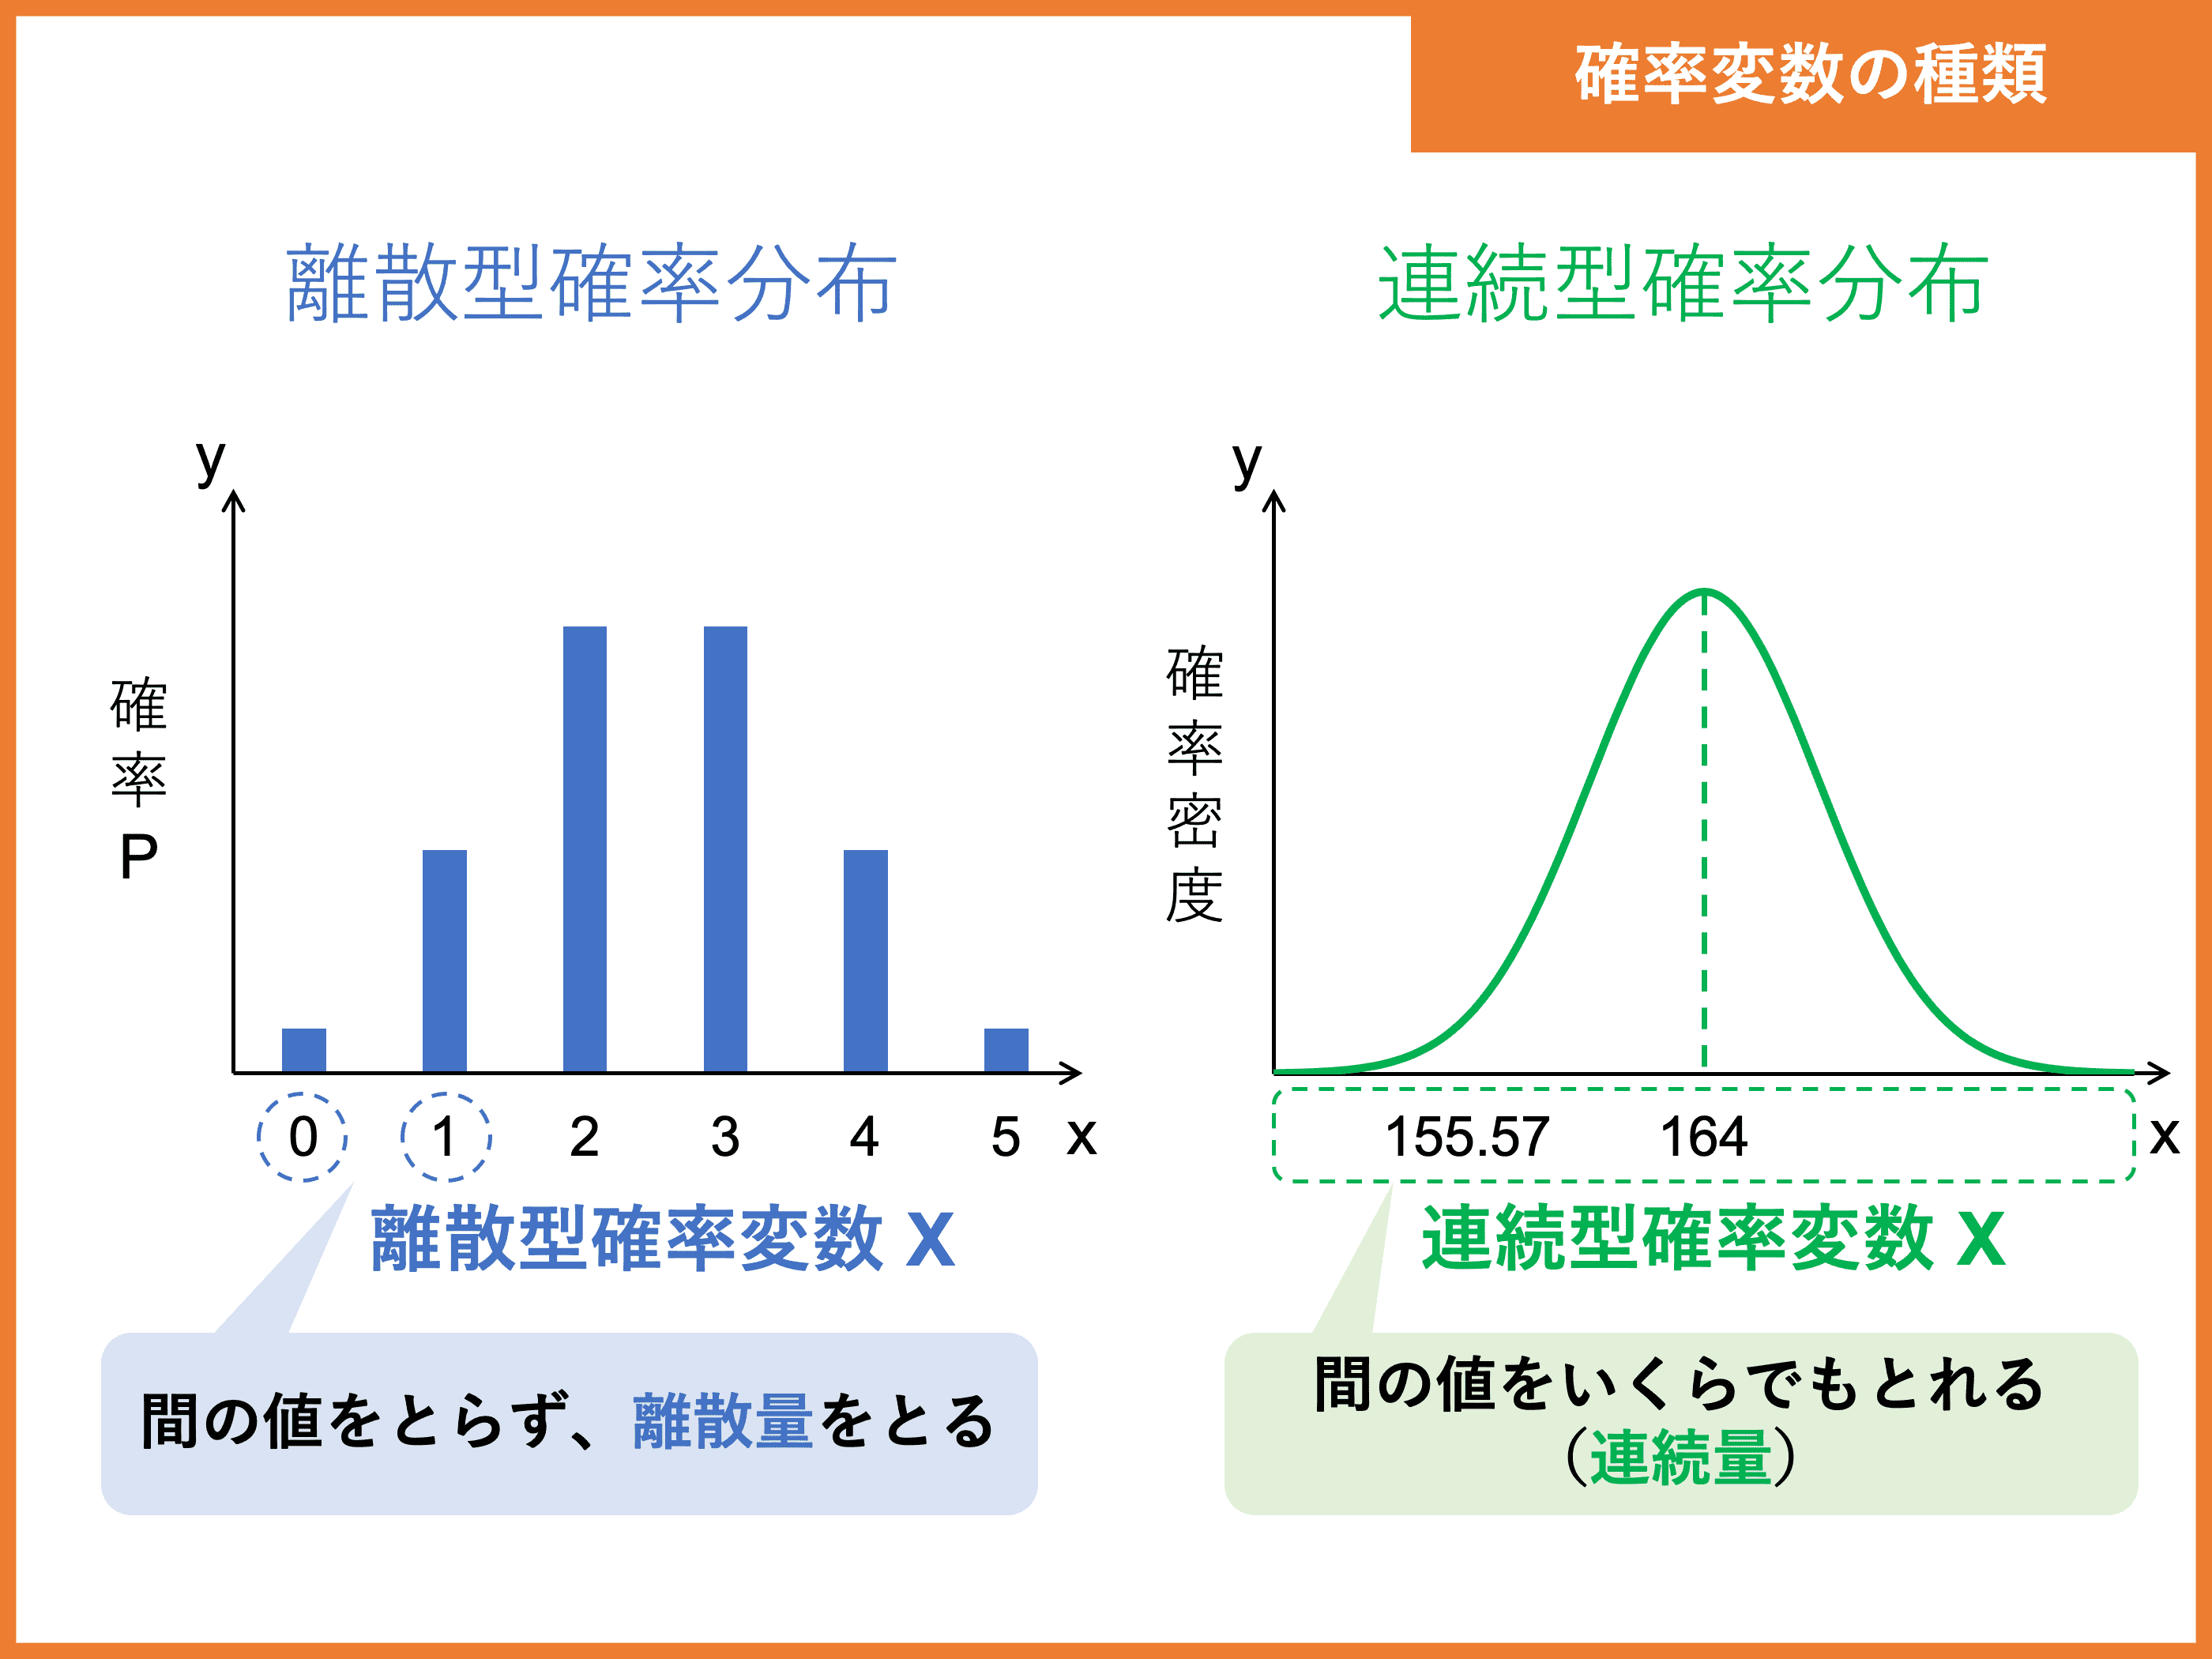
- 要点2:サイコロの目のような「離散型」と、身長や時間のように途切れのない「連続型」の2種類に分かれる。
- 要点3:確率分布・期待値・分散とセットで捉えることで、データ分析や統計モデリングの実践理解が深まる。
【直感解説】確率変数の定義とは?数学の「通常の変数」との決定的な違い
中学校の方程式で登場する「変数 $x$」は、計算を進めれば「$x = 3$」のように決まった1つの値(確定値)に定まります。これに対して確率変数の定義を一言で表すなら、「試行を行うまでどの値になるか決まらず、それぞれの値をとる確率があらかじめ定まっている変数」です。
たとえば明日の降水量、コインを投げたときの表裏、あるいはWebサイトのクリック数などは、実際に結果が出るまで確定しません。このように「偶然性(ランダム性)」を帯びた現象を数学的に扱うために、結果ごとに数値を割り振ったものが確率変数です。通常、大文字の $X$ や $Y$ で表記され、実際に観測された具体的な値(実現値)は小文字の $x$ や $y$ で区別します。
確率変数と変数の違いを整理すると、前者は「確定した単一の数値」ではなく、「確率のルールに従って取り得る値の全体像を内包した枠組み」を指している点が最大の特徴です。
【具体例で納得】サイコロとコインで紐解く「離散型確率変数」の仕組み
イメージを掴むために、もっとも身近な具体例であるサイコロを考えてみましょう。1つのサイコロを振ったときに出る目を $X$ と置くと、$X$ がとる値は $1, 2, 3, 4, 5, 6$ のいずれかです。どの目が出るかは振るまで分かりませんが、公平なサイコロであればそれぞれの目が出る確率はすべて $\frac{1}{6}$ と決まっています。
このように、値と値の間が整数などで区切られており、飛び飛びの値をひとつひとつ数えられるタイプを「離散型確率変数」と呼びます。サイコロの出目のほか、テストの点数、不良品の個数、1日の来店客数などが典型例です。
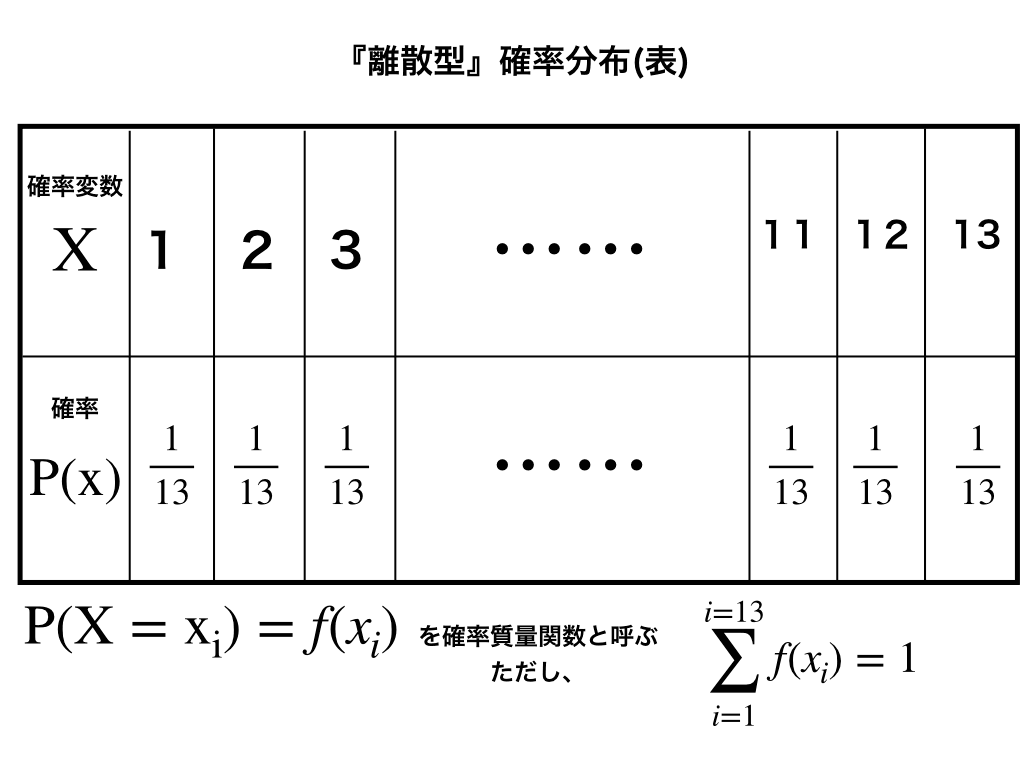
離散型確率変数において、特定の値をとる確率を対応させた関数を「確率質量関数(PMF)」と呼びます。サイコロの例であれば、$P(X = 1) = \frac{1}{6}$、$P(X = 2) = \frac{1}{6}$ といった対応表そのものが、確率の全体構造を示しています。
身長や時間の測定はどう表す?「連続型確率変数」と確率密度関数
飛び飛びの数とは対照的に、値が途切れることなく連続的に変化するケースも存在します。人間の身長、体重、気温、工場の製造設備の寿命(稼働時間)などがこれに該当し、これらを「連続型確率変数」と呼びます。
連続型を扱う際に注意すべきは、「身長がピッタリ170.0000…cmになる確率」を求めようとすると、数学的には $0$ になってしまう点です。連続した無限の目盛りを持つため、1点ピンポイントではなく「170cm以上171cm未満の範囲に収まる確率」のように、区間(幅)を指定して確率を計算します。
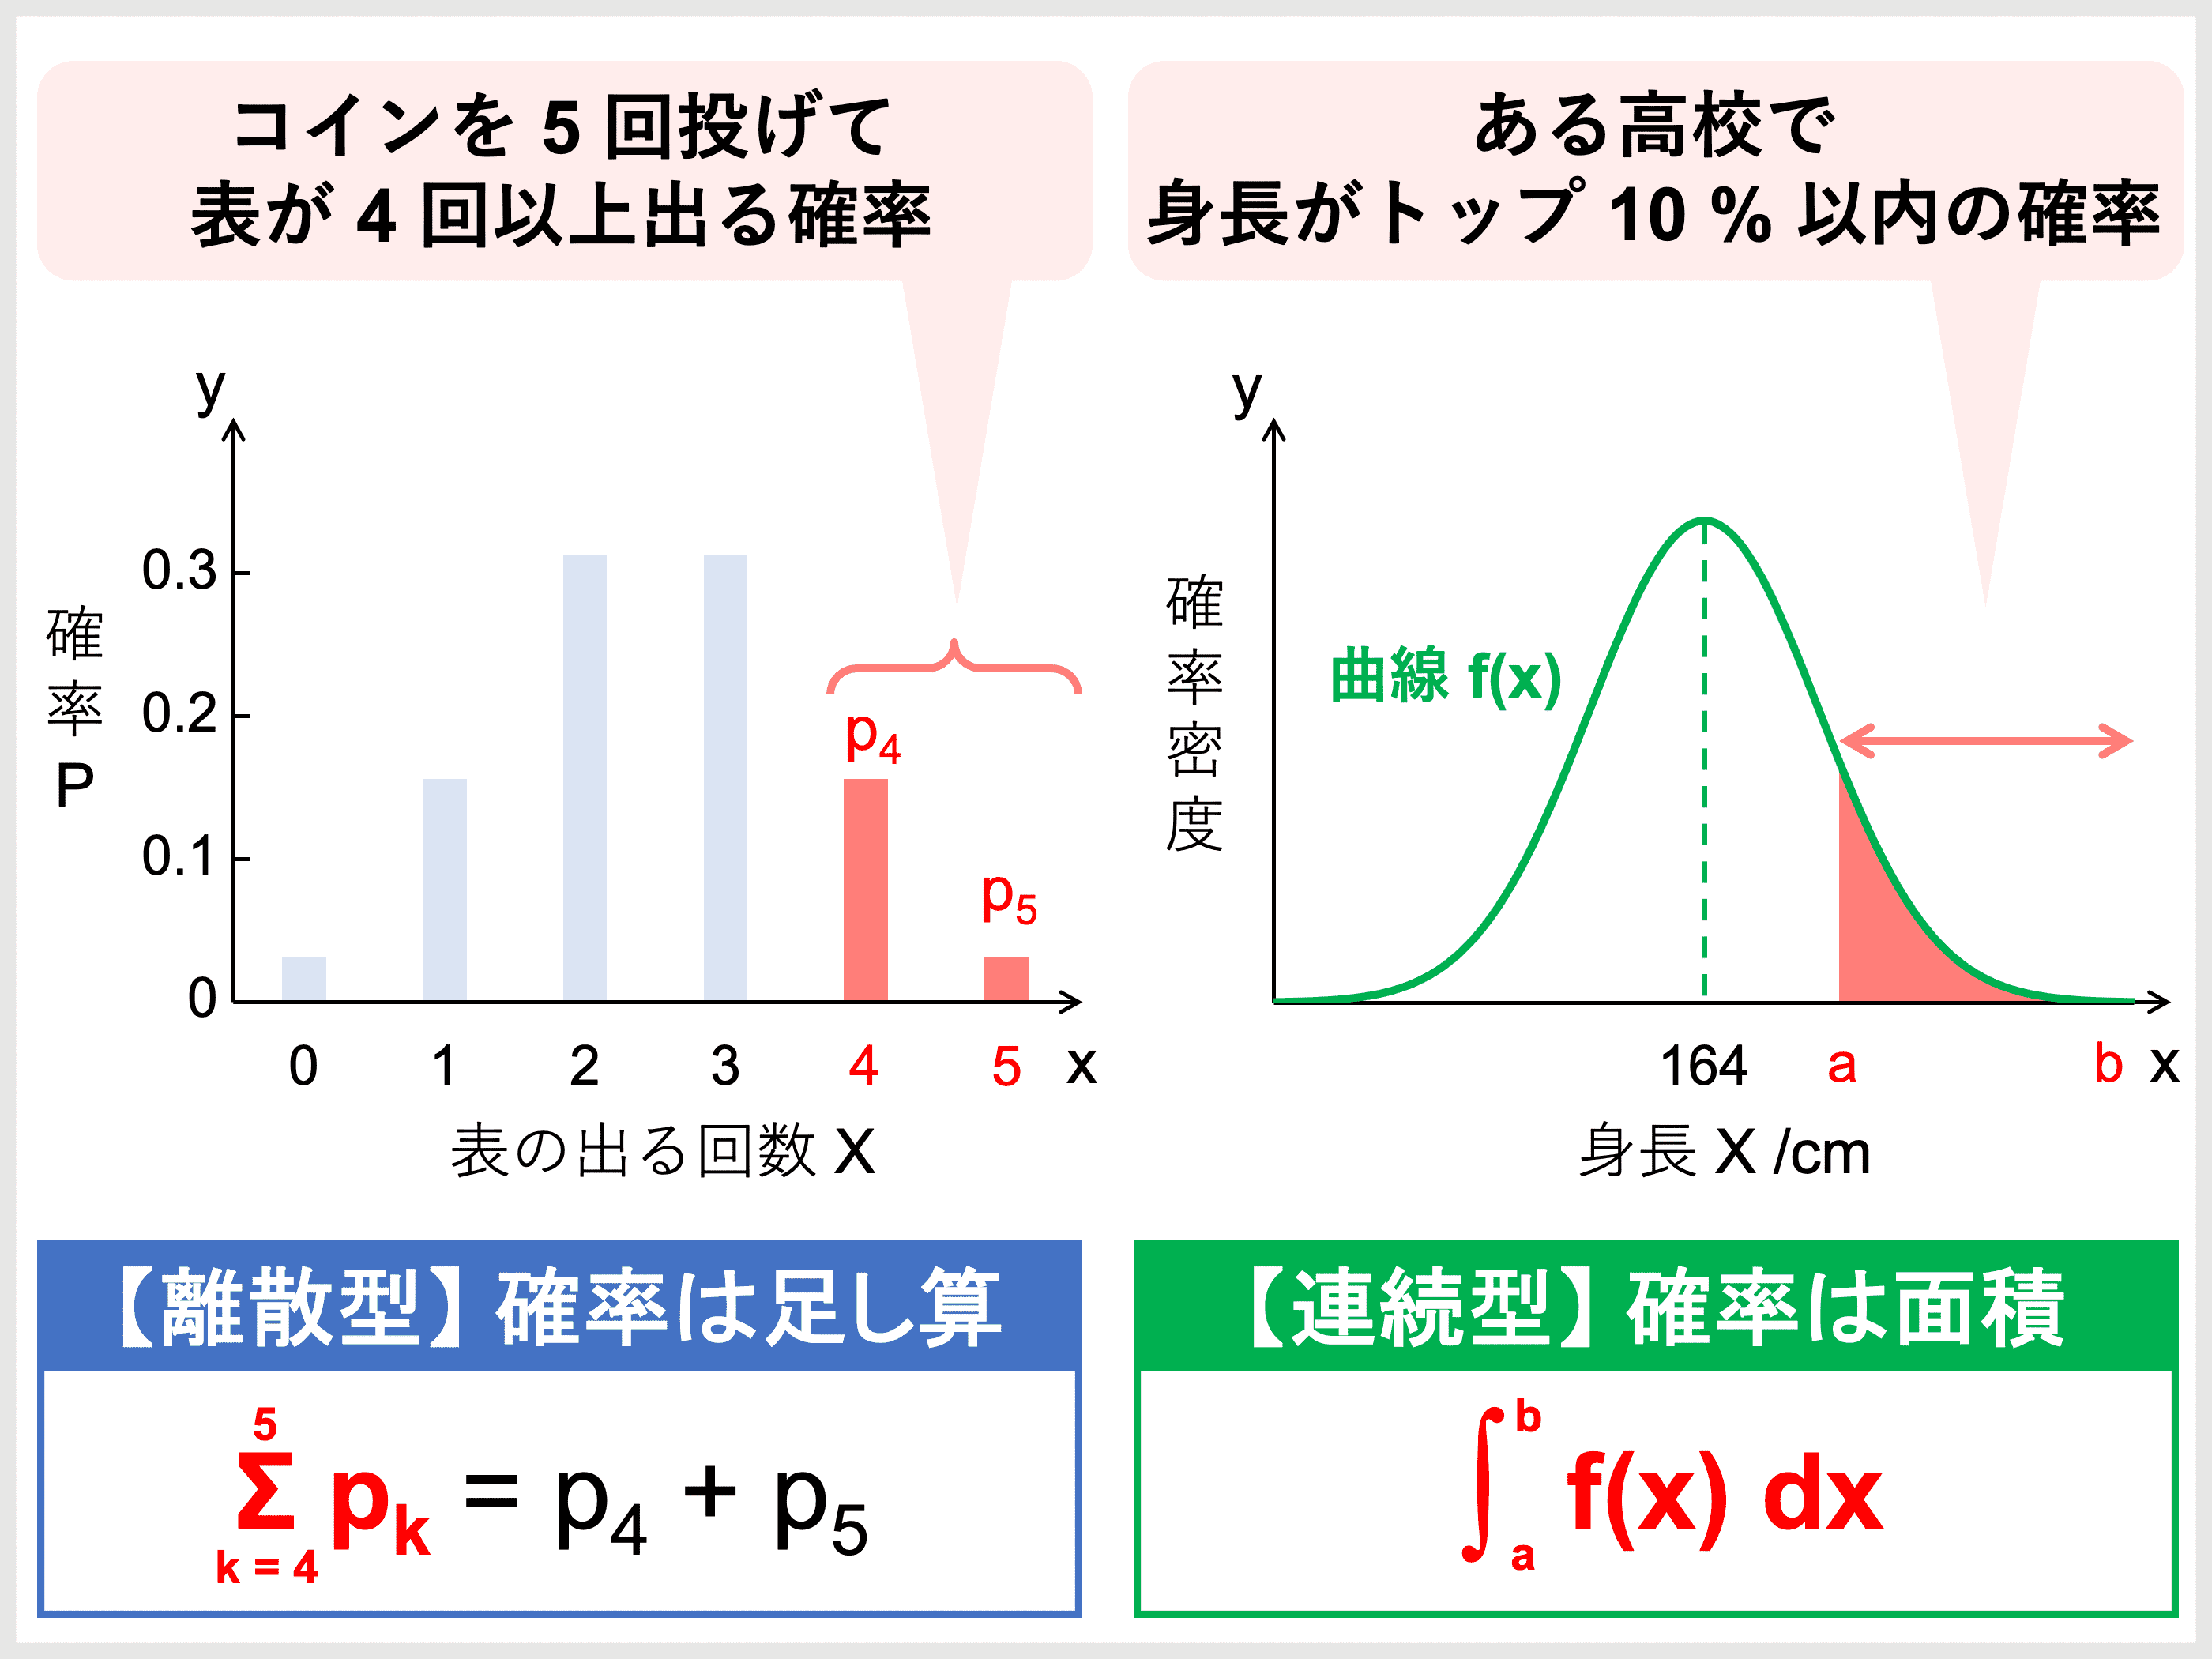
このとき、確率の「散らばり具合」や「どこに値が集中しやすいか」をグラフの曲線で表したものが「確率密度関数(PDF)」です。曲線の高さそのものが確率を示すのではなく、「指定した区間と曲線の間にある面積」がその事象の発生確率を表すという構造を押さえておくと、正規分布などの理解もスムーズに進みます。
確率分布を特徴づける2大指標|「期待値と分散」の関係性を整理
確率変数がどのような値を取りやすいかというパターン全体を示したものを「確率分布」と呼びます。そして、その確率分布の性質を一目で把握するための代表値が「期待値」と「分散」です。
期待値(平均値)は、「その試行を無限に繰り返したときに得られる数値の見込み」を示します。サイコロの出目 $X$ の期待値は、各値に確率を掛けて合計した $(1+2+3+4+5+6) \times \frac{1}{6} = 3.5$ と計算できます。ビジネスであれば「施策1回あたりの期待売上」などを試算する軸となります。
一方の分散は、「数値が期待値の周りにどれくらいバラついているか」を表す指標です。期待値が同じ施策であっても、分散が小さければ手堅い成果が見込める反面、分散が大きければ大当たりか大外れかのハイリスク・ハイリターンな構造を持つことが分かります。確率変数を使いこなす上では、この2つの指標をセットで捉える視点が欠かせません。
統計検定やデータ分析で必須!確率変数を実務で活用する視点
統計検定の合格を目指す際も、実務の機械学習モデルを構築する際も、確率変数の理解はすべての基礎になります。売上予測、リスク管理、A/Bテストの有意差判定など、現代のデータドリブンな意思決定は「現実の出来事を確率変数に置き換えてモデリングする」作業そのものだからです。
たとえばWebマーケティングにおいて、「ユーザーが広告をクリックするか否か」は $0$ または $1$ をとるベルヌーイ確率変数として定式化されます。現実世界の曖昧な事象を数字の枠組みに落とし込む力こそが、データ分析スキルの根幹を支えています。
【確率変数とは】に関するよくある質問(FAQ)
Q1:確率変数と通常の変数の一番簡単な見分け方は何ですか?
A1:その数値が「試行する前から1つの値に決まっているか(確定値)」、「サイコロのように結果が出るまで偶然に左右されるか(確率的)」で見分けられます。偶然性によって値が変動し、取り得る値に確率が割り当てられているものが確率変数です。
Q2:離散型確率変数と連続型確率変数で、計算方法はどう変わりますか?
A2:離散型は特定の値が出る確率を単純に「足し算(総和 $\sum$)」して計算します。一方、連続型は1点の確率が $0$ になるため、確率密度関数を使って指定した区間の面積を「積分($\int$)」して確率を求めます。
Q3:確率変数を理解すると統計検定でどんなメリットがありますか?
A3:2級や準1級で出題される二項分布、ポアソン分布、正規分布といった各種の確率分布が「どのような確率変数を前提にした式なのか」を直感的に見抜けるようになります。公式の丸暗記から脱却でき、応用問題への対応力が格段に高まります。
まとめ:確率変数の本質を押さえてデータ活用の土台を固める
確率変数は、一見すると難解な数式記号に見えますが、その実態は「偶然起こる出来事を数学の世界で扱うための翻訳ルール」に過ぎません。離散型と連続型の違い、そして確率分布や期待値・分散との繋がりを整理できれば、統計学の難所は一気に乗り越えやすくなります。
データの読み解きや予測モデルの活用が加速するこれからの時代だからこそ、基礎となる概念を正しく押さえ、日々の学習やデータ分析の実務に役立てていきましょう。 (出典: 確率 変数 と は(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
